Capítulo 05 · Checkout
Colas
El usuario no tiene que esperar el PDF. Pedido 456, at-least-once, outbox, DLQ.
19 min intro
Alguien pulsa Comprar
Imaginate que seguimos en la misma tienda. Ya tenemos base de datos: el pedido tiene que nacer en Postgres. Ya tenemos load balancer delante de varias APIs y CDN para las fotos. Ya tenemos caché para la ficha. Ahora Ana elige las zapatillas, ingresa la tarjeta y pulsa Comprar. El sistema tiene que guardar el pedido, reservar stock, cobrar, mandar un email y, a veces, generar una invoice en PDF.
La forma ingenua es hacerlo todo en la misma request HTTP. El navegador espera. La API guarda la fila en Postgres, llama a Stripe, llama al inventario, llama al email, genera el PDF y entonces responde. Si Stripe tarda tres segundos y el PDF otros ocho, Ana mira un spinner once segundos. Si el gateway corta a los diez, el cobro puede haber salido y ella ve un error: un infierno de soporte.
Hay otro problema, más silencioso. Ese endpoint ahora conoce a Payment, a Inventory, a Email y a Billing. Si Email se cae, ¿falla el checkout? Si mañana añadís fraude, ¿tocás otra vez el mismo código?
El 456 no necesita que el email exista antes de decirle «pedido recibido». El cobro sí importa, pero no tiene por qué bloquear el hilo HTTP hasta el final. Parte del trabajo puede ocurrir después. Esa es la puerta de entrada a las colas.
Qué es una cola, sin misterio
Una cola es un intermediario. Un proceso deja un mensaje — «nació el pedido 456» — y sigue. Otro proceso, cuando puede, lo recoge. Quien produce no espera a quien consume. Ni siquiera tiene que saber su nombre.
Ese intermediario suele llamarse broker. RabbitMQ, SQS, Kafka: personalidades distintas, la misma idea. Escribís un mensaje, el broker lo guarda un rato, y un worker lo lee y actúa.
Order API → broker → worker de pago
                  → worker de email
                  → worker de stock
El mensaje es un trozo de datos, casi siempre JSON:
{
  "event_id": "evt_789",
  "type": "OrderCreated",
  "order_id": 456,
  "amount": 89.90
}
event_id va a importar mucho más adelante. De momento alcanza con esto: la API ya no hace el trabajo pesado. Deja constancia de que pasó algo y responde al usuario.
Lo que ganás al dejar de esperar
Si la API solo guarda el pedido y publica OrderCreated, puede responder en milisegundos. El cobro, el stock y el email ocurren en workers, cada uno a su ritmo.
Ganás desacople. Mañana un worker de fraude también escucha OrderCreated y no tocás la API de checkout. Ganás espacio para trabajo que puede esperar: el PDF, los thumbnails, la newsletter — nada de eso merece bloquear a un humano con el dedo en la pantalla.
Ganás un colchón para los picos. En Black Friday los workers de email no dan abasto; sin cola, esas requests fallan, y con cola los mensajes esperan. Vale para un pico corto. Si el pico es el nuevo ritmo de la tienda, la cola solo esconde que no hay capacidad.
Y ganás que un proceso muerto no se lleve el trabajo entero. Si el worker de email se estrella a mitad, el mensaje puede volver. El precio de ese milagro es que el mensaje puede aparecer otra vez — y de eso trata casi todo el resto del capítulo.
También escalás aparte: si el email va lento, añadís workers de email sin redeployar el checkout.
Lo que no deberías meter en una cola
Una cola no es el pegamento por defecto de los microservicios. Es un desvío. Añade latencia, duplicados, un sistema más que puede romperse y una caja negra: «¿dónde está el 456?» deja de ser una query simple en la base de datos.
Si el usuario necesita la respuesta en esta request — el precio final, si la tarjeta es válida, si queda talla 42 — eso no se va a una cola. Una regla práctica: si tu SLA es de unos pocos cientos de milisegundos, meter una cola en medio suele romperlo. El checkout puede aceptar el pedido rápido. No puede decir «éxito» y cobrar mañana si el producto promete cobro inmediato: ahí el cobro sigue en el camino crítico, o diseñás un estado PENDING honesto y se lo explicás a Ana.
Nunca empieces por «¿pongo Kafka?». Empieza por «¿este trabajo puede esperar, y qué pasa si se hace dos veces?».
El worker se muere a la mitad
El 456 está en la cola. Un worker de pagos lo recoge, llama a Stripe, Stripe dice OK, y justo entonces la máquina se reinicia. ¿El mensaje se perdió? ¿Se cobró? ¿Las dos cosas?
El broker no adivina si el trabajo terminó. Espera un ACK: «ya lo hice, podés olvidarte». Si el worker muere antes del ACK, el broker asume que no se hizo y lo reentrega. Eso se llama redelivery, y es el corazón de lo que sigue.
Hay tres promesas que vas a oír, y conviene no mezclarlas.
Con at-most-once, el mensaje llega cero o una vez. Si el worker muere, puede perderse. Sirve para un contador de «usuarios mirando esto». No sirve para cobrar.
Con at-least-once, el mensaje llega como mínimo una vez: el broker insiste hasta el ACK. El 456 se va a intentar cobrar. Si el crash fue después de cobrar y antes del ACK, el siguiente worker lo vuelve a intentar — y podés terminar con dos cobros. Esta es la semántica real de casi todos los brokers que vas a usar en producción.
Exactly-once suena a lo que querés. Extremo a extremo — clic, Stripe, tu base de datos, el email — es mucho más resbaladizo de lo que parece. Kafka tiene un modo que llama exactly-once dentro de su mundo; eso no convierte en exactly-once tu HTTP a Stripe. En una entrevista de system design, «Kafka garantiza exactly-once» sin decir dónde es un yellow flag. Lo honesto: diseñamos para at-least-once y hacemos que repetir no rompa el negocio.
Si el ACK va demasiado pronto y el worker se cae, el mensaje ya desapareció y nadie hace el trabajo. El orden sano es este:
- Recibir el mensaje
- Transacción en tu base de datos
- Trabajo local
COMMIT- ACK al broker
Si morís antes del commit, no hay rastro y el mensaje vuelve. Si morís después del commit y antes del ACK, el mensaje vuelve pero tu base de datos ya sabe que el 456 se procesó. Eso es idempotencia.
El mismo mensaje, dos veces
Idempotente significa: una vez o diez, el mismo resultado. Poner el pedido en CONFIRMED diez veces sigue siendo CONFIRMED. Cobrar 89,90 € diez veces es 899 €, y eso no es el mismo resultado.
Cuando asumís at-least-once, todo consumer tiene que soportar el mismo event_id otra vez. La forma amateur es mirar primero y escribir después:
SELECT * FROM processed_events WHERE event_id = 'evt_789'
-- si no existe, proceso e inserto
Dos workers hacen ese SELECT a la vez, los dos ven vacío, los dos cobran. La barrera tiene que ser la base de datos: event_id UNIQUE, en la misma transacción que el update de negocio.
BEGIN
INSERT INTO processed_events(event_id) VALUES ('evt_789')
UPDATE orders SET status = 'CONFIRMED' WHERE id = 456
COMMIT
Si el segundo llega, el INSERT choca, hay rollback, y se va. No hace falta un «if not exists» en la aplicación: la constraint es el adulto en la sala.
Cómo no cobrar dos veces
El worker llama a Stripe, Stripe cobra, y antes del COMMIT el proceso muere. Stripe ya tiene el dinero. En tu base de datos el cobro sigue PENDING. El broker reentrega. processed_events no ayuda: el primer intento no llegó a escribir.
Hace falta una segunda capa: que Stripe trate la operación como idempotente. Una clave que vos elegís y reutilizás en cada reintento:
POST /payments
Idempotency-Key: payment-order-456
La primera vez cobra. La segunda, con la misma clave, no vuelve a mover dinero. Sin esta capa, un consumer «idempotente» en tu base de datos igual duplica pagos.
Son dos capas con trabajos distintos. Una evita reprocesar el evento adentro de tu sistema. La otra evita repetir un efecto afuera, en el proveedor. El email de gracias dos veces es feo. El cobro doble es un incidente.
El mensaje que no se puede procesar
Si Stripe responde 503, tiene sentido reintentar: a lo mejor en treinta segundos vuelve. Si el mensaje trae un customer_id que no existe, o un JSON roto, reintentar es calentar CPU. Eso es un poison message: va a fallar siempre, da igual cuántas veces lo tires.
Si reintentás al instante y hay diez mil mensajes porque Stripe está caído, cuando Stripe vuelve todos disparan a la vez. Eso es un retry storm. Por eso usás backoff — 1s, 2s, 4s — más jitter, y un techo: después de N intentos, el mensaje se va a una Dead Letter Queue.
La DLQ no es una papelera. Es una sala de espera con alarma. Alguien mira, arregla el dato o el bug, y hace replay si el negocio lo pide. «Falló → DLQ → nos olvidamos» es cómo se pierden pedidos en silencio.
Created después de Cancelled
Ana se arrepiente. Salen OrderCreated y después OrderCancelled. Si un worker lento procesa primero la cancelación y después la creación, el pedido termina «creado» cuando ya lo habían anulado. El orden importa para este pedido. No el de toda la tienda.
La herramienta es una partition key. En Kafka, partition_key = order_id: todo lo del 456 cae en la misma partición y lo consume un worker a la vez; el 457 puede ir a otra. Más orden estricto, menos paralelismo. FIFO global es el throughput de un solo worker, y casi nunca lo necesitás. La pregunta no es «¿hace falta orden?». Es «¿orden de qué?».
La cola que no para de crecer
Entran 300 pedidos por segundo. Los workers de pago hacen 200. Cada segundo la cola gana cien mensajes. Un minuto de eso es un colchón razonable; una hora son 360.000 de retraso. La cola no estaba absorbiendo el pico: estaba escondiendo que no hay capacidad.
Las métricas que importan son queue depth y consumer lag. Si crecen sin parar, no es un Black Friday de quince minutos: es un déficit. Añadir workers ayuda hasta que el cuello es Stripe, Postgres, o una partición caliente. En Kafka, el paralelismo de un consumer group no supera el número de particiones.
Cuando no da, aplicás backpressure: 429 en el checkout, priorizar (cobrar antes que el email), cortar lo no esencial. Autoescalar workers mirando el lag tiene sentido. Autoescalar la API porque su CPU está baja, mientras la cola se hincha, no: estás midiendo el lugar equivocado.
Guardar el pedido y avisarle al resto
El checkout hace dos cosas que parecen una: INSERT en orders y publicar OrderCreated. Son dos sistemas. Postgres puede decir que sí y el broker que no: el pedido existe, hay un 200 al usuario, y nadie cobró. Al revés: el evento vuela y la orden no está.
Eso es el dual write. No se arregla con un try/catch alrededor del publish. Se arregla haciendo las dos escrituras una sola transacción en un solo sitio: la base de datos.
BEGIN
INSERT INTO orders ...
INSERT INTO outbox (event_id, type, payload) ...
COMMIT
Un relay lee la outbox y publica en el broker. Si hubo commit, el evento existe en Postgres y tarde o temprano sale. El relay también se muere: puede publicar y caer antes de marcar published_at, entonces republica. Volvemos a at-least-once. El outbox elimina el agujero «está en la base de datos y no se enteró nadie»; los workers siguen siendo idempotentes.
CDC (Debezium leyendo el WAL) es la versión «si esto crece». En una entrevista de system design o en una entrevista técnica, mencionar outbox ya te pone en el sitio correcto.
Pedido, stock y pago no caben en un BEGIN
El 456 necesita stock y cobro y pedido confirmado. A veces viven en empresas distintas — Stripe de un lado, tu inventario del otro —. No hay un BEGIN de Postgres que las cubra. Si reservás stock y Stripe falla, tenés que compensar: soltar el stock. Si cobrás y no hay stock, devolver el dinero. Eso es una saga: una secuencia de pasos locales con compensaciones, no una sola transacción distribuida mágica.
Un orden que suele doler menos: reservar stock antes de cobrar. Si no hay talla 42, ni tocás la tarjeta de Ana.
Hay dos estilos. En coreografía, cada servicio escucha eventos y publica los siguientes: elástico, y con el tiempo se vuelve un ovillo difícil de dibujar. En orquestación, un director dice el siguiente paso: el flujo se lee en un sitio, y el riesgo es un dios que conoce todos los recovecos.
Para un checkout de tres o cuatro pasos, un orquestador se explica mejor en una pizarra. El 456 puede orquestar stock + pago + confirmar, y aún así emitir OrderConfirmed para que email y analítica escuchen sin estar metidos dentro de la saga.
Una cola, un tablón o un diario
No todos los brokers cuentan la misma historia.
Una cola de trabajo entrega un mensaje a un worker y, con el ACK, el mensaje desaparece. «Cobra este pedido». Rabbit y SQS viven acá.
Un pub/sub deja que el mismo suceso lo vean varios consumidores. OrderCreated lo quieren fraude, analítica y el dashboard. Muchos pub/sub son efímeros: si el consumidor estaba caído, se lo perdió.
Un event stream (Kafka) es un diario. Los sucesos se quedan, en orden por partición. Cada equipo lee a su ritmo, con su offset. Un consumidor nuevo puede reprocesar el mes pasado. Eso no lo hace una cola clásica.
Podés usar Kafka como si fuera una cola, pero el modelo mental sigue siendo diario. Brilla cuando vas a tener varios lectores o replay. Brilla menos si solo querías mandar emails y ya estás en AWS: SQS existe para eso.
Rabbit, Kafka o SQS
No elijas por velocidad de folleto. Elige por el modelo.
SQS si el problema es una bandeja de jobs, estás en AWS, y no querés operar un cluster. El 456 como «cobra esto» encaja.
RabbitMQ si necesitás enrutado fino y el patrón es productor → broker → worker.
Kafka si el suceso es el dato: varios equipos leen orders, querés retener, hacer replay y partir por clave.
«Kafka es rápido y Rabbit lento» no es un argumento. «Necesito replay y tres consumidores independientes» sí lo es.
Cómo te enterás de que esto va mal
Sin métricas, la cola es una caja negra con pedidos adentro. Mirás profundidad o lag (¿hay capacidad?). Latencia de procesamiento. Tasa de error y de retry. Tamaño de la DLQ: si pasa de cero, alguien tiene que enterarse. Si el lag crece veinte minutos, también.
Un trace_id que nace en el HTTP del Comprar y viaja hasta Stripe te salva la vida. Si no, reconstruir el 456 es arqueología entre tres logs que no se conocen.
El pedido 456, entero
Ana pulsa Comprar. La API, en una transacción, escribe orders (PENDING) y una fila en outbox. Commit. 201. Ella ya no espera el PDF.
Un relay publica OrderCreated. Inventory reserva la talla 42. Si no hay, el pedido pasa a CANCELLED y no se toca el dinero. Si hay, Payment cobra con Idempotency-Key: payment-order-456. Si Stripe falla un rato, retry con backoff. Si el mensaje está podrido, DLQ. Si Stripe cobra y el worker muere, el redelivery no vuelve a cobrar: la clave de Stripe lo impide. El UNIQUE de event_id impide el doble CONFIRMED.
Los eventos del 456 van con partition_key = 456. Email y analítica escuchan OrderConfirmed en otro grupo. Si Black Friday hincha la cola, sumás workers; si aún no da, el checkout dice 429.
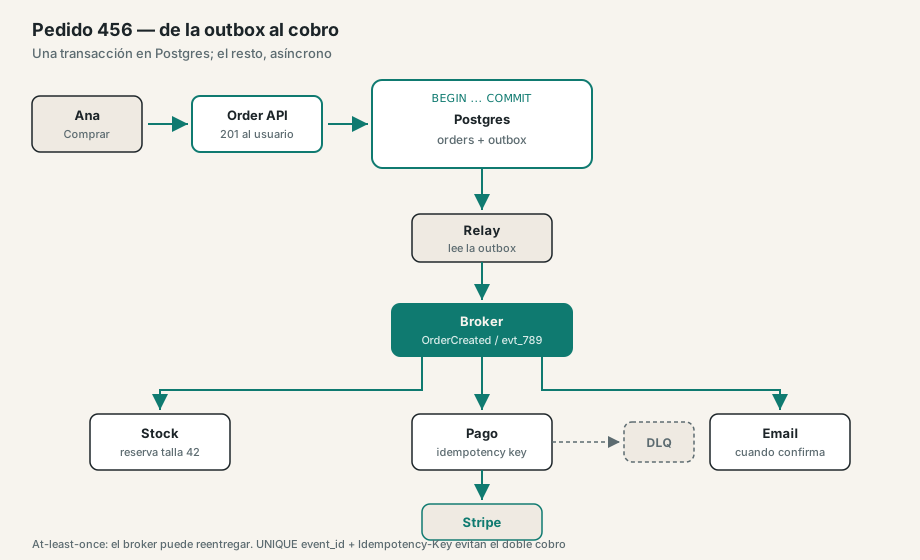
Una transacción en la base de datos; el resto, asíncrono. El broker puede reentregar: por eso el UNIQUE del event_id y la idempotency key hacia Stripe.
Qué espera cada nivel
Un mid pone una cola, dice at-least-once e idempotencia, y nombra una DLQ.
Un senior no hace ACK antes de commitear, pone UNIQUE en la misma transacción, usa idempotency key hacia Stripe, outbox para el dual write, orden por order_id (no global), y trata el lag como un problema de capacidad.
Si te lo preguntan
¿Por qué una cola en el checkout? The checkout should not wait for the PDF; we accept the order, persist it, and process payments and mail asynchronously.
¿Si el worker crashea? We assume at-least-once, so the message may come back; consumers are idempotent.
¿Y si llega dos veces? A unique event id in the same database transaction as the business update — not a SELECT then INSERT.
¿Cómo no cobrás dos veces? An idempotency key on the payment provider.
¿La base de datos dijo que sí y el evento no salió? Transactional outbox. The relay can still duplicate; consumers still must be idempotent.
¿El mensaje falla siempre? Retries with backoff for outages; poison messages go to a DLQ that we actually look at.
¿Hace falta orden? Per order, not global — partition by order_id.
¿La cola no para de crecer? That is a capacity problem hiding in the buffer; scale consumers and apply backpressure.
¿Kafka o Rabbit? Rabbit or SQS for a work queue; Kafka when we need a durable log, replay, and several independent readers.